Асинхронный Django в продакшене: что ломается под нагрузкой
Автор: Кирилл Сермягин
Асинхронные представления есть в Django с версии 3.1, асинхронный интерфейс ORM — с 4.1, и за пять лет вокруг них накопилось много ожиданий. Чаще всего async включают в надежде, что сервис «станет быстрее». Под нагрузкой выясняется другое: асинхронное представление ускоряет только ожидание внешних вызовов, а база данных, пул соединений и синхронный код вокруг остаются прежними.
В этом гайде разбираем сервис расчёта доставки из доклада на Moscow Python Meetup №110: где асинхронность дала выигрыш, что сломалось на 800 запросах в секунду и какие настройки PostgreSQL и пула соединений это исправили. Код проверен на Python 3.13 и Django 6.0.
Что на самом деле делает async-представление
Под ASGI-сервером (uvicorn, granian, daphne) каждый воркер — это процесс с циклом событий. Асинхронное представление выполняется прямо в этом цикле: пока оно ждёт ответа от сети, воркер обслуживает другие запросы. Синхронные представления под ASGI тоже работают, но каждое уходит в отдельный поток через sync_to_async — это дороже, чем под WSGI.
Поэтому смысл async-представления — выполнять несколько независимых ожиданий одновременно. В нашем сервисе ответ складывается из заказа в базе и двух внешних API: тарифов перевозчиков и прогноза времени доставки.
import asyncio

import httpx
from django.http import JsonResponse

from .models import Order

TIMEOUT = httpx.Timeout(2.0, connect=0.5)


async def delivery_quote(request, order_id: int):
    order = await Order.objects.select_related("warehouse").aget(pk=order_id)
    async with httpx.AsyncClient(timeout=TIMEOUT) as client:
        rates, eta = await asyncio.gather(
            fetch_rates(client, order),
            fetch_eta(client, order),
        )
    return JsonResponse({"order": order.pk, "rates": rates, "eta": eta})
Два запроса к внешним API идут параллельно: вместо 40 + 45 мс ждём около 45. На этом выигрыш и заканчивается — запрос к базе по-прежнему выполняется синхронно, просто в другом потоке. Клиент httpx в продакшене лучше держать один на процесс — об этом в чек-листе в конце.
Синхронное middleware
Django проверяет каждое middleware в цепочке. Если хотя бы одно умеет работать только синхронно, обработчик адаптируется в поток на каждом запросе, и выгода от async пропадает. Включите логгер django.request на уровне DEBUG: строки «Synchronous handler adapted for middleware…» покажут, кто виноват. У нас это было самописное middleware аудита и старая версия CORS-пакета.
Отключение клиента
С Django 5.0 асинхронное представление узнаёт, что клиент закрыл соединение: в нём выбрасывается asyncio.CancelledError. Для сервиса доставки это значит, что запросы к перевозчикам, которые уже никому не нужны, отменяются вместе с представлением. Если после отмены нужно что-то записать — например, метрику, — перехватите исключение, сделайте это и выбросьте его снова.
Синхронное представление так не умеет: поток доработает до конца, даже если пользователь давно ушёл со страницы. На медленных эндпоинтах под нагрузкой это заметная экономия воркеров.
Когда async не нужен
- Представление только читает из базы и рендерит шаблон — выигрыша не будет, а переключение потоков добавит задержку.
- Тяжёлые вычисления на CPU блокируют цикл событий целиком — все запросы воркера ждут.
- Синхронные библиотеки без async-версии: каждый вызов придётся оборачивать в
sync_to_async.
ORM и sync_to_async
Методы с префиксом a — aget(), acount(), asave(), итерация через async for — выглядят асинхронными, но внутри ORM синхронная. Каждый такой вызов Django отправляет в поток через sync_to_async(thread_sensitive=True): в рамках одного запроса все они выполняются в одном потоке, по очереди.
Отсюда первая ловушка: десяток мелких ORM-вызовов в async-представлении — это десяток переключений между циклом событий и потоком. На нашем стенде одно переключение стоило 0,1–0,3 мс, а в представлении корзины их набиралось больше сорока. Решение — собрать работу с базой в одну синхронную функцию и переключиться один раз.
from asgiref.sync import sync_to_async
from django.db import transaction

from .models import Order, Reservation


def _reserve(order_id: int, slots: list[int]) -> Order:
    with transaction.atomic():
        order = Order.objects.select_for_update().get(pk=order_id)
        Reservation.objects.bulk_create(
            Reservation(order=order, slot_id=slot) for slot in slots
        )
        order.status = Order.Status.RESERVED
        order.save(update_fields=["status"])
    return order


reserve = sync_to_async(_reserve)  # одно переключение вместо пяти
Для одиночных операций обёртки не нужны: у менеджеров и QuerySet есть асинхронные версии почти всех методов. Старые примеры из документации и статей лучше обновить.
Итерация по большим выборкам
async for order in Order.objects.filter(…) загружает выборку частями, но каждая часть — отдельное переключение в поток. Для выгрузки на десятки тысяч строк это медленнее, чем один синхронный проход с .iterator(chunk_size=2000) внутри функции, обёрнутой в sync_to_async. Правило то же, что и выше: чем крупнее кусок работы в потоке, тем меньше накладных расходов.
Пул соединений PostgreSQL
Под WSGI соединение с базой живёт в потоке воркера и переиспользуется благодаря CONN_MAX_AGE. Под ASGI так не получается: потоки для sync_to_async создаются под запросы, постоянные соединения копятся в них, пока PostgreSQL не ответит too many clients already. Именно это случилось у нас на 800 запросах в секунду.
С Django 5.1 у бэкенда PostgreSQL есть встроенный пул на psycopg 3. Он включается одной опцией, а CONN_MAX_AGE при этом должен быть равен нулю:
DATABASES = {
    "default": {
        "ENGINE": "django.db.backends.postgresql",
        "NAME": "delivery",
        "CONN_MAX_AGE": 0,  # с пулом — только 0
        "OPTIONS": {
            "pool": {
                "min_size": 4,
                "max_size": 20,
                "timeout": 5,  # секунд ждать свободное соединение
            },
        },
    },
}
Размер пула считайте от лимита сервера: max_size, умноженный на число воркеров на всех подах, должен оставаться меньше max_connections с запасом для миграций и администраторов. Если подов больше пяти, поставьте перед базой PgBouncer в режиме transaction и выключите серверные курсоры — DISABLE_SERVER_SIDE_CURSORS = True, иначе .iterator() начнёт падать.
Пример расчёта: у нас три пода по четыре воркера uvicorn и max_connections = 300. При max_size = 20 получается 3 × 4 × 20 = 240 соединений — остаётся 60 на миграции, cron-задачи и подключения дежурных. При автомасштабировании до пяти подов лимит закончится, поэтому на этом этапе мы и поставили PgBouncer.
timeout в настройках пула — сколько запрос ждёт свободное соединение. Слишком большое значение прячет проблему: запросы копятся в очереди, и вместо понятной ошибки пользователь получает ответ через 30 секунд. Пять секунд и алерт на PoolTimeout — разумный старт.
Что мониторить
| Метрика | Норма | Где смотреть |
|---|---|---|
| Активные соединения | < 80 % от max_connections | pg_stat_activity |
| Ожидание свободного соединения | < 5 мс, p95 | метрики psycopg_pool |
| Таймауты пула | 0 | логи приложения, PoolTimeout |
| Время запросов к базе | не растёт вместе с RPS | pg_stat_statements |
Долгие ответы и стриминг
Второй сценарий, где async окупается без оговорок, — долгие ответы. Расчёт сложного маршрута у нас занимает до восьми секунд: раньше клиент ждал, а поток gunicorn был занят целиком. Теперь представление отдаёт прогресс через Server-Sent Events, а воркер в это время обслуживает другие запросы.
import json

from django.http import StreamingHttpResponse


async def route_progress(request, route_id: int):
    async def events():
        async for step in planner.stream(route_id):
            payload = json.dumps({"step": step.name, "done": step.done})
            yield f"data: {payload}\n\n"

    return StreamingHttpResponse(events(), content_type="text/event-stream")
Асинхронный итератор в StreamingHttpResponse поддерживается с Django 4.2. Под WSGI такой ответ держит поток всё время стрима, под ASGI — только корутину. Не забудьте выключить буферизацию на прокси: для nginx — заголовок X-Accel-Buffering: no, иначе клиент получит все события разом в конце.
Замеры
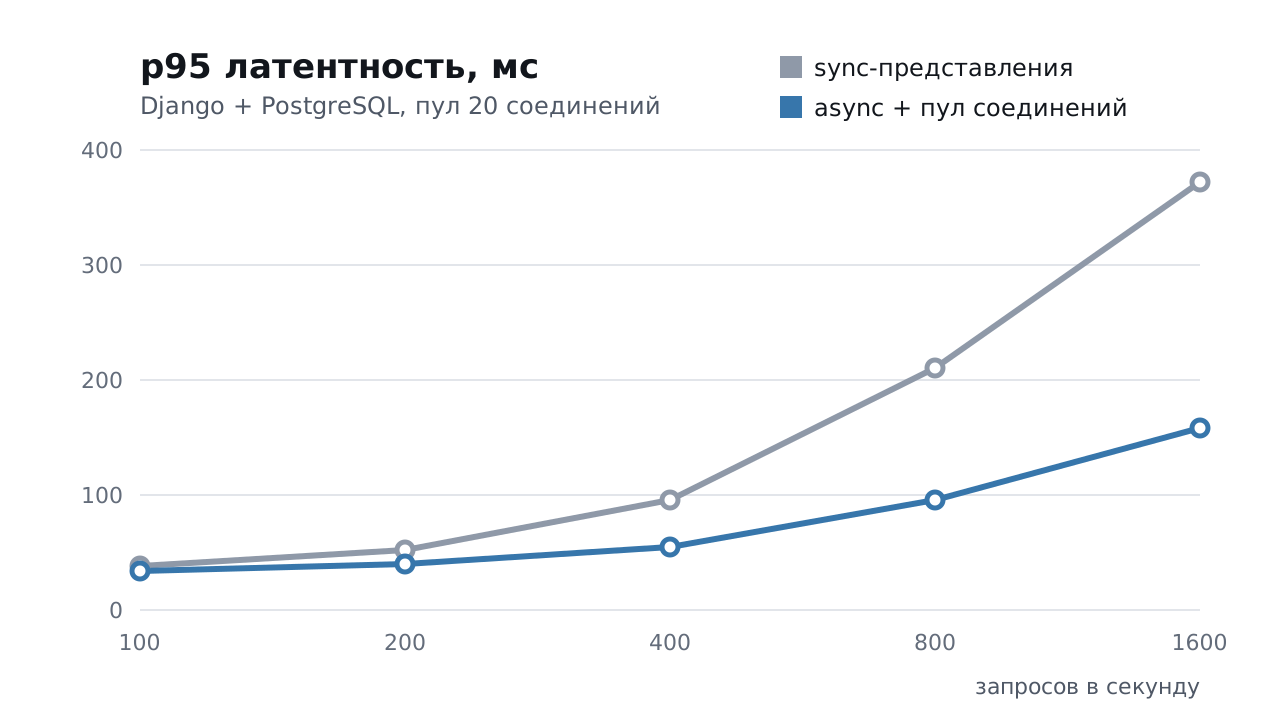
Стенд: четыре воркера uvicorn против gunicorn с четырьмя воркерами по восемь потоков, PostgreSQL 17 на отдельной машине, внешние API заменены заглушками с задержкой 40–45 мс. Нагрузку подавали Locust ступенями от 100 до 1600 запросов в секунду, по пять минут на ступень.
| Нагрузка, RPS | sync, p95 | async + пул, p95 |
|---|---|---|
| 100 | 38 мс | 34 мс |
| 400 | 96 мс | 55 мс |
| 800 | 210 мс | 96 мс |
| 1600 | 372 мс | 158 мс |
Выигрыш в 2,3 раза на 1600 RPS дают параллельные вызовы внешних API и то, что воркер не простаивает, пока они идут. Запрос к базе в обоих вариантах занимает одинаковые 3–4 мс. Без пула async-вариант на 800 RPS был хуже синхронного: 12 % ответов с ошибкой 500 из-за исчерпанных соединений.
Расход ресурсов тоже изменился: на 1600 RPS синхронный вариант держал 32 потока и около 1,9 ГБ памяти на под, асинхронный — 4 процесса и 0,8 ГБ. Загрузка CPU почти не отличалась: сервис упирается в ожидание сети, а не в вычисления. Если бы эндпоинт считал маршруты сам, картина была бы обратной.
Сценарий нагрузки — обычный Locust-файл. Число пользователей равно целевому RPS: каждый делает один запрос в секунду, пока сервис успевает отвечать.
import random

from locust import FastHttpUser, constant_throughput, task


class QuoteUser(FastHttpUser):
    wait_time = constant_throughput(1)  # запрос в секунду на пользователя

    @task
    def quote(self):
        order_id = random.randint(1, 50_000)
        self.client.get(f"/api/orders/{order_id}/quote", name="/quote")
Чек-лист перед переносом в прод
- Найдите представления, которые ждут сеть: только их имеет смысл переводить на async.
- Включите пул psycopg и поставьте
CONN_MAX_AGE = 0. - Соберите работу с базой в синхронные функции и вызывайте их через
sync_to_asyncодин раз. - Держите один
httpx.AsyncClientна процесс и задавайте таймауты явно. - Проверьте middleware: одно синхронное заставит Django переключаться в поток на каждом запросе.
- Снимите p95 до и после под нагрузкой, похожей на продакшен.
Как выкатывать
Мы переводили эндпоинты по одному: async-версия представления жила рядом с синхронной, а балансировщик отправлял на неё сначала 5 %, потом 50 % и наконец весь трафик. Откат — переключение веса, без деплоя. Сравнивать варианты удобно по одному дашборду: p95, доля ошибок и ожидание пула на соседних графиках.
Запуск, на котором сняты замеры выше:
uvicorn config.asgi:application \
  --workers 4 --loop uvloop --http httptools \
  --limit-concurrency 400 --timeout-keep-alive 5
Итоги
Асинхронный Django окупается там, где сервис ждёт сеть: внешние API, очереди, LLM-провайдеры. Если представление в основном ходит в базу, сначала займитесь запросами и индексами — поможет гайд про N+1. А если решили переходить, начните с пула соединений: без него асинхронность под нагрузкой делает только хуже.
Что изменилось за год эксплуатации, Алексей рассказал в выпуске подкаста 212. Вопросы по гайду задавайте в чате сообщества — ответы с примерами добавим в следующую редакцию.